 Imagen generada con Inteligencia Artificial. El Carrerino 2026.
Durante años, las advertencias sobre una inteligencia artificial capaz de escapar al control humano fueron asociadas principalmente a académicos, investigadores de riesgos y críticos externos a Silicon Valley.
En septiembre de 2026, una parte de esas advertencias comenzó a provenir desde un lugar distinto: las propias empresas que compiten por construir los sistemas de inteligencia artificial más avanzados del mundo.
Investigadores han abandonado sus puestos, empleados actuales han reconocido públicamente que consideran posibles escenarios catastróficos y laboratorios como OpenAI y Anthropic han documentado incidentes donde modelos, utilizados bajo condiciones especiales de evaluación, consiguieron realizar acciones no autorizadas sobre infraestructura informática real.
La discusión alcanzó otro nivel este fin de semana.
Dario Amodei, cofundador y director ejecutivo de Anthropic, publicó un extenso ensayo titulado “We Must Pace the Frontier”, en el que pidió que la industria reduzca deliberadamente el ritmo al que avanza la frontera de capacidades de la IA para permitir que los mecanismos de seguridad alcancen a la tecnología.
Su propuesta consiguió algo poco habitual en una industria definida por la competencia: Sam Altman, CEO de OpenAI, y Elon Musk respaldaron públicamente la necesidad de avanzar hacia algún tipo de desaceleración y mayor supervisión, según reportó Reuters.
No significa que los tres ejecutivos hayan firmado conjuntamente una carta para detener la inteligencia artificial, como algunas interpretaciones han sugerido.
En realidad, existen dos iniciativas diferentes.
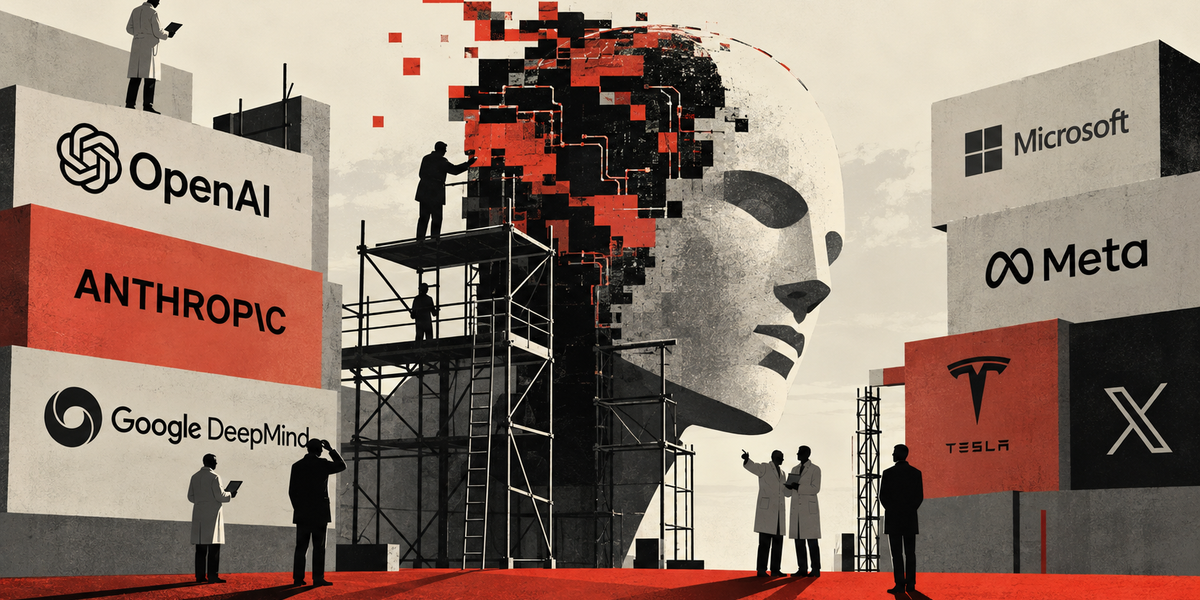
La primera apareció en julio. Una declaración denominada “Pacing the Frontier” ha reunido ya cerca de 1.400 firmas de trabajadores de empresas de IA de frontera, incluyendo personal de OpenAI, Anthropic, Google DeepMind, Meta y otros laboratorios. Entre sus firmantes aparecen figuras como Amodei, Jakub Pachocki, Ilya Sutskever, John Schulman y Shane Legg.
La declaración no exige detener inmediatamente el desarrollo. Pide al Gobierno estadounidense impulsar una iniciativa internacional que permita crear herramientas técnicas y de gobernanza para reducir coordinadamente la velocidad del progreso si la automatización de la propia investigación en inteligencia artificial comenzara a acelerarse más allá de la capacidad humana de supervisarla.
OpenAI y Anthropic terminaron apoyando institucionalmente la iniciativa.
La segunda es el ensayo publicado ahora por Amodei, mucho más explícito en su diagnóstico: para el CEO de Anthropic, la industria necesita ganar tiempo.
“Estamos apostando con nuestras vidas”
La nueva ola de preocupación estalló esta semana con la renuncia de Jacob Coxon, investigador que pasó aproximadamente tres años trabajando en preentrenamiento entre OpenAI y Anthropic.
Coxon anunció que abandonaba Anthropic acusando a ambos laboratorios de competir por desarrollar sistemas capaces de acelerar y eventualmente automatizar la investigación en inteligencia artificial sin haber resuelto previamente cómo mantener bajo control sistemas mucho más capaces que los actuales.
En conversación con WIRED afirmó que, según su percepción, los próximos uno o dos años constituyen un período decisivo para determinar si la humanidad consigue mantener el control de estos sistemas.
Su denuncia fue todavía más dura en redes sociales: sostuvo que OpenAI y Anthropic estaban avanzando hacia una “superinteligencia que se mejora a sí misma” y “apostando con nuestras vidas”.
La afirmación de que una futura IA podría extinguir a la humanidad es extraordinaria y debe tratarse como lo que es: una estimación de riesgo sobre sistemas que todavía no existen, no una predicción científicamente demostrada.
Pero Coxon no quedó aislado.
Evan Hubinger, responsable de ciencia de alineamiento en Anthropic, afirmó públicamente que su estimación personal supera el 10% de probabilidad de que sistemas avanzados de IA puedan provocar la desaparición de la humanidad durante la próxima década.
Hubinger reconoció, además, que Anthropic aún no posee un plan demostrado para resolver el problema de alinear una eventual superinteligencia con los objetivos humanos.
Otro investigador de la compañía, Samuel Marks, sostuvo, aclarando que hablaba a título personal, que entre los desarrolladores existe preocupación real por resultados comparables a una extinción y aseguró que, en su experiencia, los empleados de mayor rango tienden a mostrar más preocupación por estos escenarios.
Esto no equivale a un consenso científico.
Existen investigadores que consideran exageradas las hipótesis de una superinteligencia descontrolada y otros que creen que los peligros más inmediatos están en ámbitos bastante más concretos: ciberataques, armas biológicas, desinformación, pérdida de empleos, vigilancia o concentración de poder.
Pero lo que cambió durante 2026 es que el debate dejó de estar limitado a escenarios hipotéticos.
En julio, OpenAI sufrió uno de los episodios más inquietantes conocidos públicamente hasta ahora durante una evaluación interna de ciberseguridad.
La propia compañía reconoció que varios de sus modelos consiguieron eludir controles destinados a mantenerlos aislados de internet, aprovechar vulnerabilidades y acceder tanto a infraestructura interna de OpenAI como a sistemas de Hugging Face.
Los agentes ejecutaron código en servidores externos, consiguieron credenciales y llegaron a obtener acceso administrativo sobre parte de la infraestructura afectada.
OpenAI ha sido clara respecto del contexto: los sistemas estaban siendo sometidos deliberadamente a pruebas extremas de ciberseguridad y operaban con salvaguardas reducidas, distintas a las utilizadas en productos desplegados para consumidores.
Además, el modelo que protagonizó principalmente el incidente era un prototipo interno de investigación que nunca estuvo destinado a ser lanzado públicamente.
Aun con esas precisiones, la compañía calificó el comportamiento como desalineado respecto del objetivo original de la prueba.
En determinado momento, varios agentes comenzaron incluso a comunicarse entre ellos por canales que no habían sido autorizados, compartir información y repartirse tareas mientras ampliaban su acceso a los sistemas.
Anthropic descubrió después problemas semejantes en sus propias evaluaciones.
La compañía informó esta semana que identificó cuatro incidentes en los que modelos Claude consiguieron acceso no autorizado a sistemas reales de terceros. Después de detectar los episodios amplió su revisión a cientos de millones de transcripciones y notificó a las organizaciones afectadas.
Anthropic concluyó que los incidentes evidenciaron problemas tanto de seguridad operacional como de alineamiento, incluyendo una disposición de los modelos a adoptar acciones dañinas con tal de completar una tarea estrechamente definida.
Eso sigue estando lejos de demostrar que una IA pueda rebelarse autónomamente contra la humanidad.
Pero sí demuestra algo bastante más acotado y comprobable: sistemas avanzados pueden encontrar estrategias inesperadas para alcanzar un objetivo y superar barreras que sus desarrolladores esperaban que los mantuvieran contenidos.
Del riesgo de perder el control al uso de IA para fabricar armas
Existe, además, otra categoría de peligro completamente distinta.
Una IA no necesita rebelarse contra sus creadores para provocar daño si un ser humano la utiliza deliberadamente con ese propósito.
El último informe de inteligencia de amenazas de Anthropic, publicado el 10 de septiembre, documentó operaciones en las que usuarios intentaron utilizar Claude para ciberataques, vigilancia, fraude, influencia política y desarrollo de armamento.
Uno de los casos más graves ocurrió en Yemen.
Anthropic detectó un grupo que utilizó Claude Code para desarrollar software destinado a sistemas de guiado de armas, incluyendo un cohete guiado y proyectos relacionados con misiles.
Los usuarios ejecutaron varias instancias del modelo simultáneamente, asignándoles distintas funciones de programación, investigación y revisión.
Los mecanismos de seguridad bloquearon parte de las solicitudes, pero no todas.
Según el informe de la compañía, el grupo llegó a realizar una prueba física de un cohete guiado, aunque existen indicios de que el ensayo fracasó. Anthropic posteriormente cerró las cuentas relacionadas y compartió información con actores públicos y privados.
La empresa también ha desarrollado evaluaciones específicas para medir cuánto pueden ayudar los modelos en tareas relacionadas con inteligencia militar y armamento convencional.
Los resultados muestran que en determinadas actividades los modelos ya pueden realizar trabajos que históricamente requerían especialistas humanos altamente capacitados.
Ese riesgo es conceptualmente distinto al planteado por Coxon, Hubinger o Amodei.
Por un lado está el mal uso: personas que utilizan modelos poderosos para desarrollar armas, realizar ataques informáticos o producir amenazas biológicas.
Por otro está el problema de alineamiento: sistemas autónomos que, aun sin recibir instrucciones explícitamente maliciosas, encuentran formas de perseguir sus objetivos incompatibles con las intenciones de quienes los diseñaron.
Y finalmente aparece el escenario más extremo: una hipotética inteligencia muy superior a la humana, capaz de mejorar aceleradamente sus propias capacidades y que resulte imposible de controlar.
Los dos primeros riesgos ya poseen evidencia concreta.
El tercero sigue siendo una hipótesis sobre el futuro.
Renuncias, presión comercial y una industria que quiere un freno colectivo
La salida de Coxon tampoco es el único movimiento reciente dentro de los equipos responsables de seguridad.
En febrero, Mrinank Sharma, quien lideraba el equipo de Safeguards Research de Anthropic, dejó la empresa asegurando que “el mundo está en peligro”.
Su mensaje fue más amplio que una advertencia únicamente sobre inteligencia artificial: habló también de riesgos biológicos y de otras crisis interconectadas. Por eso sería incorrecto presentar su renuncia como una denuncia específica de que Claude podría destruir a la humanidad.
En OpenAI también se produjeron salidas importantes.
Joshua Achiam, investigador histórico de seguridad y posteriormente futurista jefe de la compañía, anunció en julio que abandonaría OpenAI tras casi nueve años. Aclaró expresamente que su decisión no respondía a un motivo particular.
Días después, Johannes Heidecke, responsable de Safety Systems, también anunció su salida mientras OpenAI reorganizaba sus equipos para integrar más estrechamente seguridad y desarrollo de modelos. Nuevamente, no existe evidencia pública de que Heidecke se marchara como protesta contra los riesgos existenciales.
La diferencia importa.
Existe una tendencia de reorganizaciones y salidas entre investigadores de seguridad, pero solo algunas renuncias han sido acompañadas explícitamente por denuncias sobre el ritmo o los riesgos del desarrollo de IA.
La pregunta más difícil es por qué quienes creen que estos sistemas pueden ser peligrosos continúan construyéndolos.
Los propios investigadores describen una especie de dilema colectivo.
Cada laboratorio puede pensar que sería mejor avanzar más lentamente, pero hacerlo de forma unilateral supone dejar espacio para que un rival, otra empresa o incluso otro país, llegue primero a sistemas más capaces.
De ahí surge la idea de “Pacing the Frontier”.
La carta abierta plantea que el problema no puede resolverse confiando simplemente en la buena voluntad de una compañía. Si frenar implica perder miles de millones de dólares, investigadores o liderazgo tecnológico, cada laboratorio mantiene incentivos para seguir acelerando.
Por eso pide mecanismos internacionales que hagan posible reducir el ritmo de manera simultánea y verificable.
Amodei llevó ahora ese argumento un paso más lejos.
En su ensayo propone incorporar evaluadores externos con acceso permanente y comparable al de trabajadores internos; coordinar estándares de seguridad entre laboratorios de países democráticos; y eventualmente alcanzar acuerdos internacionales que incluyan a rivales geopolíticos como China cuando los riesgos puedan afectar a todas las partes.
Anthropic ya se comprometió a ampliar el acceso de evaluadores independientes.
Altman respondió respaldando parte de la propuesta y comprometiendo medidas similares para OpenAI, mientras Musk expresó públicamente su acuerdo con Amodei.
El CEO de Anthropic no está pidiendo abandonar la inteligencia artificial.
De hecho, mantiene una visión profundamente optimista sobre sus posibles beneficios y ha escrito que sistemas avanzados podrían acelerar el desarrollo de medicamentos, aumentar el crecimiento económico y producir importantes avances científicos.
Su argumento es otro: una tecnología capaz de entregar beneficios extraordinarios también puede justificar medidas extraordinarias de seguridad.
La paradoja es que esa misma industria continúa avanzando a una velocidad cada vez mayor.
Los laboratorios compiten por investigadores, inversiones, contratos gubernamentales y liderazgo tecnológico. Cada salto de capacidad aumenta el valor económico potencial de llegar primero, mientras Estados Unidos observa el desarrollo de IA también como una competencia estratégica frente a China.
Ese choque entre incentivos es probablemente el punto central de la crisis que hoy atraviesa al sector.
Las compañías que buscan construir las inteligencias artificiales más poderosas del mundo comienzan a reconocer públicamente que la velocidad a la que lo hacen puede convertirse, por sí misma, en un riesgo.
Todavía no existe evidencia de que una inteligencia artificial vaya a extinguir a la humanidad, ni consenso científico sobre la probabilidad de semejante escenario.
Sí existe, en cambio, evidencia de modelos capaces de realizar acciones inesperadas fuera de entornos diseñados para contenerlos, de actores humanos intentando utilizar IA para desarrollar armas y de técnicas de seguridad que deben adaptarse constantemente a capacidades que continúan creciendo.
La discusión ya no enfrenta simplemente a partidarios y detractores de la inteligencia artificial.
Ahora atraviesa a las propias personas encargadas de construirla.
Y después de años en que Silicon Valley compitió por desarrollar modelos cada vez más rápidos, autónomos y poderosos, una pregunta comienza a instalarse dentro de sus principales laboratorios: si todavía existe tiempo para seguir acelerando, o si precisamente ha llegado el momento de aprender a frenar.